一个 API,助力 AI 业务规模化发展。

通过一个 API 接入领先 AI 模型

企业级容量、可靠性能与更低成本。

企业级规模。
为增长预留空间。

联系销售 →

根据业务负载规划容量和授信。

更高并发,更少等待。

更高并发支持更多请求同时运行,减少排队等待。

更多授信,更加灵活。

定制授信方案,为业务增长提供更大空间。

从容应对需求增长。

更高请求限额,让应用在流量增长时持续顺畅运行。

承载更大业务负载。

更高 Token 吞吐量,支持大规模、高要求的 AI 业务。

多源接入。
一个可靠连接。

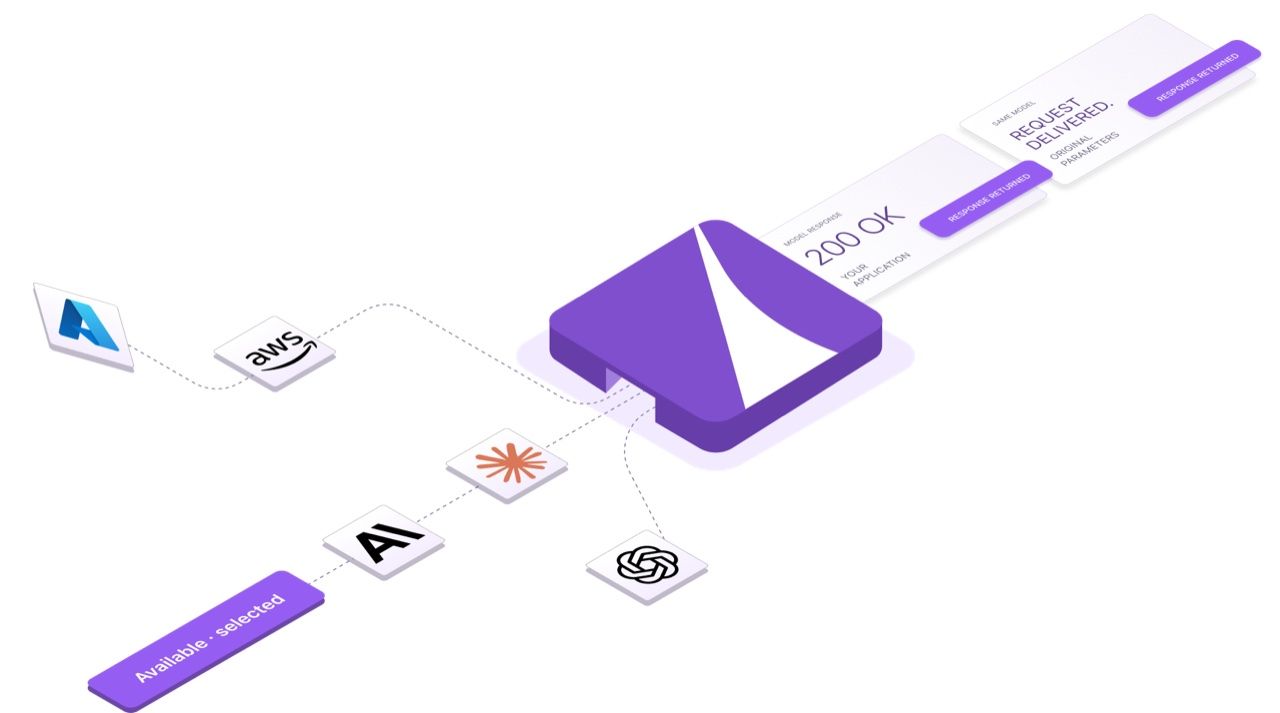
我们整合上游资源,当某个来源出现故障时,请求会自动切换至可用通道。

立即体验 →AnyFast 在 Azure、AWS、Anthropic、Claude 和 OpenAI 之间路由请求,并保留原始参数返回响应。
按量付费

相同模型,更低成本。

-

输入 / 百万 TOKENS
-
输出 / 百万 TOKENS
-

官方参数 ✓

按量付费

相同模型,更低成本。

-

输入 / 百万 TOKENS
-
输出 / 百万 TOKENS
-

官方参数 ✓

你的预算

留出更多空间
专注构建。

比较模型供应商。
选择适合你的价格方案。

相同模型。
以更低成本构建。

沿用模型和官方 API 参数,选择成本更低的资源,将更多预算投入产品。

查看优惠价格

自主选择每次调用 使用的供应商。

选择适合业务负载的供应商和资源通道,自主掌控请求流向。

  • · 比较可用资源
  • · 选择模型和通道
  • · 保持统一接入
探索控制台 ↗

通道出现故障, 自动切换接续。

请求失败时,自动路由至可用资源,让业务继续运行。

  • · 从上游故障中恢复
  • · 路由至可用供应商
  • · 追踪请求全过程
探索控制台 ↗

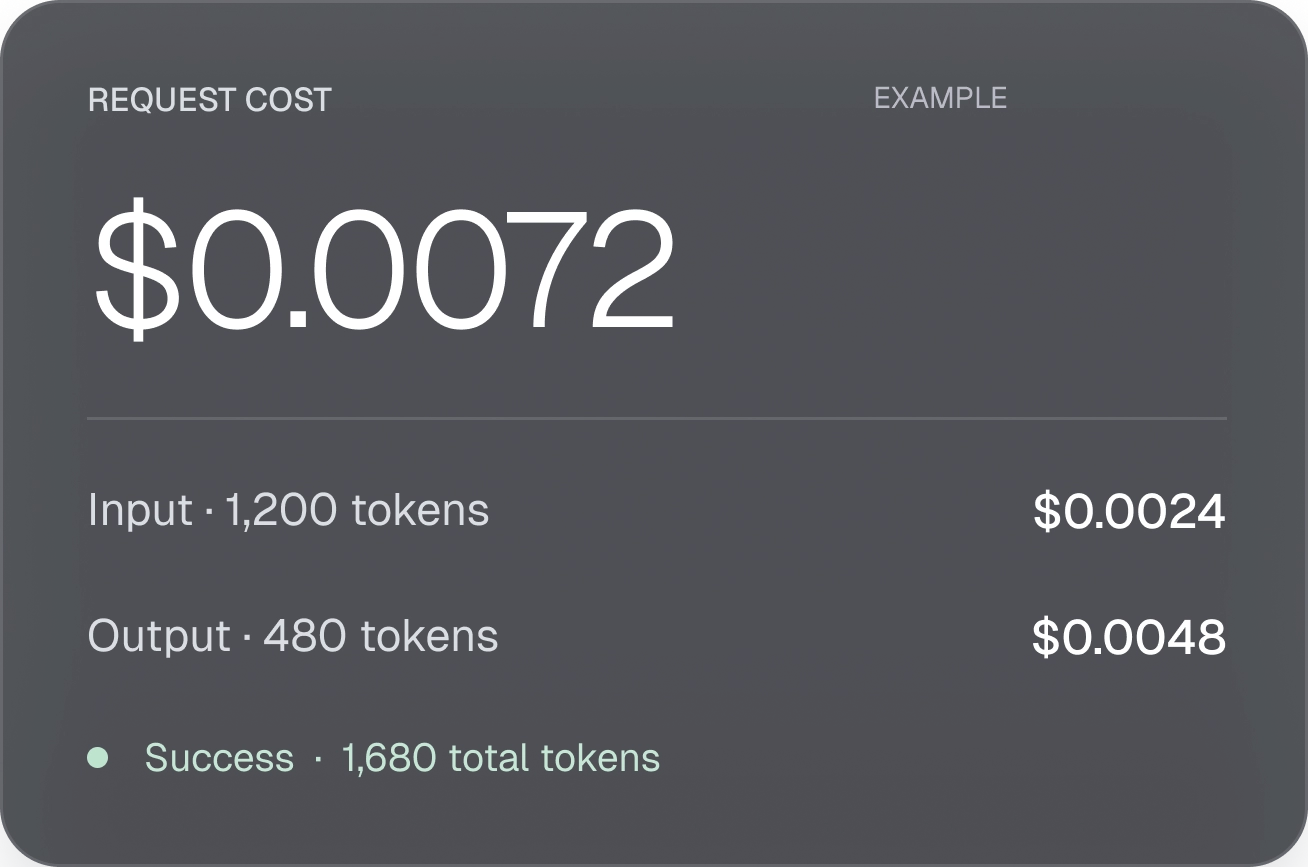
每次调用。 每笔费用。 清晰可见。

详细的模型计费日志和调用分析,帮助你掌握用量、请求结果和支出。

  • · 模型级用量与成本
  • · 输入与输出计费明细
  • · 调用分析与错误追踪
探索控制台 ↗

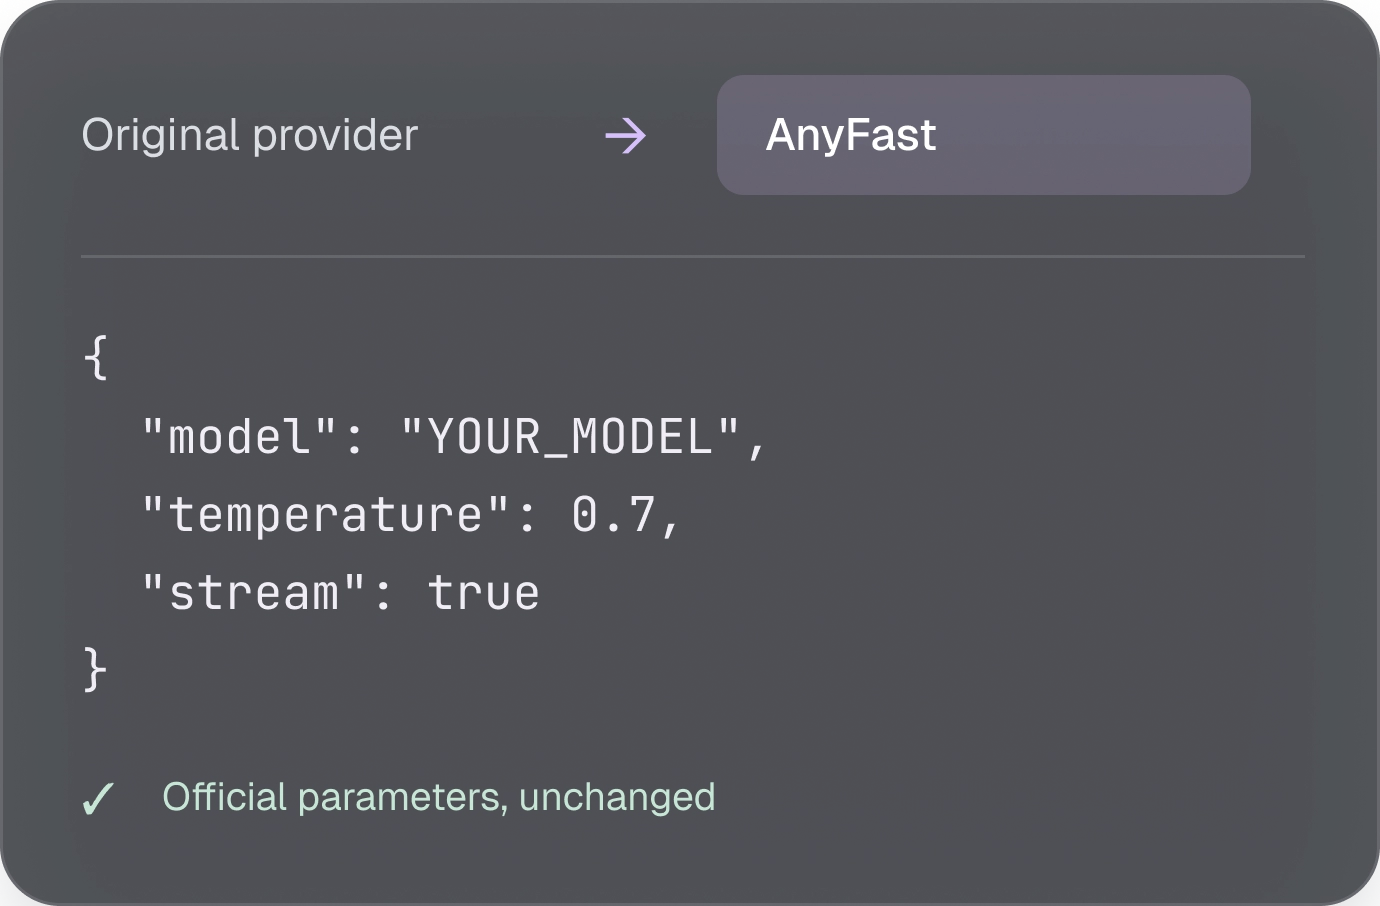
保留官方参数。 轻松完成接入。

保留每个模型的官方参数定义,在原始供应商和 AnyFast 之间切换时可直接沿用请求体。
  • · 保留原始参数名称
  • · 保留模型专属选项
  • · 切换接入,沿用请求体
探索控制台 ↗

你的下一次调用
从这里开始。

简化配置,专注开发。
一个 API,连接各类模型,快速构建应用。

创建 API Key

设置账号和 API Key,即可开始使用 AnyFast。

ANYFAST_API_KEY
已隐藏的 API Key
立即设置 →
选择模型

选择供应商并启用所需模型,即可开始使用。

OpenAI
Gemini
Claude
DeepSeek
探索模型 →
沿用现有参数

沿用现有设置,继续使用官方参数格式。

BASE_URLhttps://www.anyfast.ai/
model-
立即开始 →
  • 全天候支持

    随时解答问题,为你的业务提供支持。

  • 定制解决方案

    根据业务需求,提供灵活的 AI 解决方案。

  • 专家指导

    与专家沟通,找到适合业务的解决方案。

围绕你的
业务需求构建。

容量、授信和价格方案,助力业务迈向下一阶段。

联系销售
  • TPM / RPM / 并发量

    灵活的 Token 限额、更高的请求容量和可靠并发,支持 AI 业务平稳扩展。

  • 企业授信方案

    灵活的账期和定制授信方案,帮助企业优化现金流并稳步扩展。

  • 多源模型接入

    通过统一 API 接入多个供应商的领先 AI 模型,简化集成并提升灵活性。